

ゼロクリック時代、AIはどうやって企業を見つける? 5つの生成AIで調べてみた
目次
「日本でRAGシステムを開発している企業を教えてください」
ChatGPTやGemini、Perplexity、Copilot、Claudeといった生成AIに、こう尋ねられたとき、自社はその回答の候補に入るでしょうか。
最近はWeb検索だけでなく、生成AIにそのまま質問して情報を探すことも増えてきました。また、検索結果だけで疑問が解決し、Webサイトまで訪れない「ゼロクリック」の増加も指摘されています。実際、Pew Research Centerの調査では、GoogleでAIによる要約が表示された場合、通常の検索結果がクリックされる割合が低下する傾向が確認されています。
そうなると、これまでのように「検索結果から自社サイトへ来てもらう」だけではなく、「生成AIの回答の中で自社や自社の情報を見つけてもらえるか」という視点も重要になりそうです。
では、生成AIはどうやって企業やWebサイトを見つけているのでしょうか。検索エンジンであればSEOという考え方がありますが、生成AIの場合も同じように考えてよいのでしょうか。
そこで今回は、生成AIがWeb検索するときに内部で何をしているのかを調べたうえで、5つの生成AIに同じ質問を行い、回答や引用元にどのような違いが出るのかを確認してみました。
なお、今回の内容は「こうすれば生成AIに引用される」という方法を紹介するものではありません。公開情報から分かることと、今回の実行結果、そこから考えられる仮説を分けて整理します。
AI検索は、質問文をそのまま検索するとは限らない
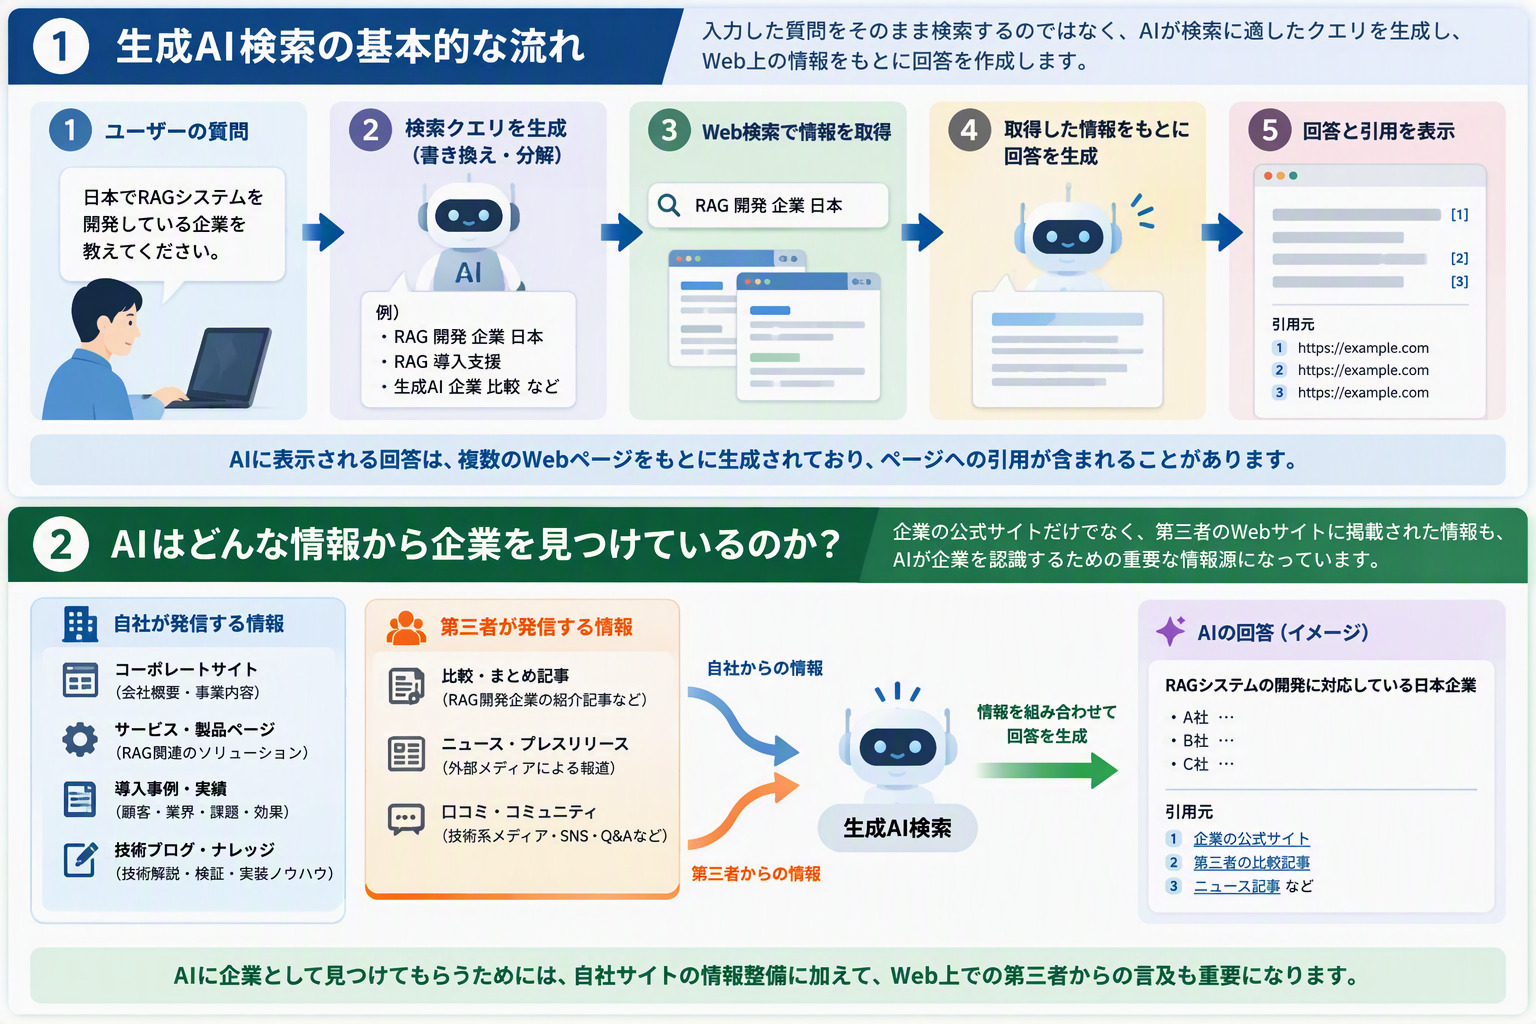
まず押さえておきたいのは、Web検索を使う生成AIが、私たちの質問文をそのまま検索するとは限らないことです。必要に応じて検索語を書き換えたり、一つの質問を複数の検索クエリへ展開したりします。
内部では、おおむね次のような流れで処理されます。
|
1 2 3 4 5 6 7 8 9 |
ユーザーの質問 ↓ 検索クエリを生成・書き換え ↓ 検索結果から候補ページを取得 ↓ 取得した情報をもとに回答を生成 ↓ 利用したページを出典として表示 |
質問文と実際の検索語の違いを大規模に計測した調査があります。GEO計測ツールを提供するProfoundは、10,000件のプロンプトをChatGPT、Perplexity、Copilotで14日間実行し、各エンジンが検索レイヤーへ送ったクエリを記録しています(Profoundの調査)。
| エンジン | 元の質問との単語重複率※ | ユニーククエリ率 |
|---|---|---|
| ChatGPT | 13% | 91% |
| Perplexity | 88% | 14% |
| Copilot | 50% | 47% |
※ 単語重複率は、各実行で生成されたクエリのうち「元の質問から最も異なるもの」を基準にした数値です。ユニーククエリ率は、ユニークなクエリ文字列数をクエリ実行総数で割った値です。
この調査では、ChatGPTは元の質問から大きく離れた検索クエリを生成する傾向があり、Perplexityは元の質問に近いクエリを使う傾向が観測されました。Copilotはその中間に位置し、質問を検索向けの短い表現へ圧縮する挙動が見られました。
ただし、これは特定期間・特定条件での観測結果です。生成AIの仕様変更や利用環境によって、結果が変わる可能性があります。
5つの生成AIに同じ質問をしてみる
では、実際に同じ質問をした場合、回答や引用されるページにも違いが出るのでしょうか。
日本でRAGシステムを開発している企業を教えてください。
今回は、ChatGPT、Perplexity、Copilot、Gemini、Claudeへ同じ質問を行いました。比較したのは、企業の優劣ではなく、次の3点です。
- 企業候補をどのように整理しているか
- どのようなページを情報源として使っているか
- 自社が候補として挙がったか
※ 以下は各AIで1回ずつ実行した結果です。常に同じ回答になることを示すものではありません。
ChatGPT:企業公式の製品ページや導入事例を参照
OpenAIの公式情報では、ChatGPT Searchは入力内容を一つ以上の検索クエリに書き換え、最初の検索結果を受けて、さらに具体的な検索を行う場合があると説明されています(ChatGPTでウェブ検索する)。
今回の回答では、8社が候補として挙げられました。単に企業名を並べるだけでなく、「個別開発」「RAG製品の提供」「クラウド上での開発支援」といった特徴や、用途に応じた選び方まで整理されていました。
引用元として目立ったのは、企業の公式サイト、製品ページ、導入事例、公式発表です。企業トップページだけでなく、その企業がRAGを使って実際に何を提供・実現しているのかが分かるページが使われていました。
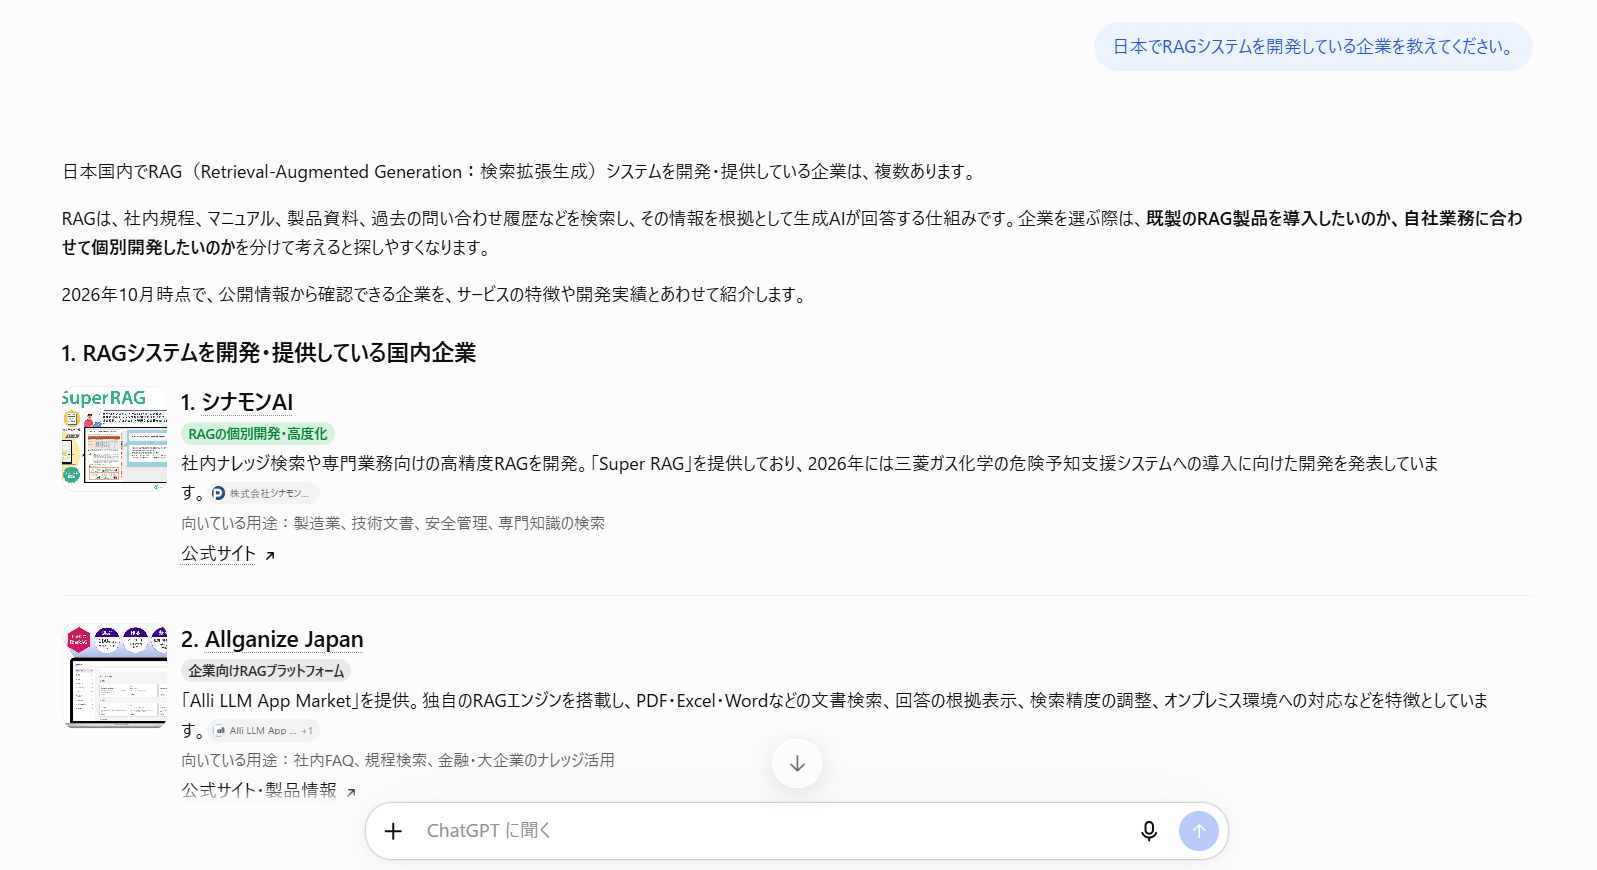
今回の結果からは、企業名やサービス名が記載されているだけでなく、取り組みや実績を具体的に確認できる情報が重要なのではないか、という仮説が立ちます。
Perplexity:公式情報に加えて、企業比較記事も参照
Perplexityの回答では、企業を「RAG製品・プラットフォーム系」と「受託開発・SIer系」に分け、それぞれの特徴や用途とあわせて候補を提示していました。
ChatGPTとの違いとして気になったのは、企業を探す際の情報源です。企業公式の発表に加えて、RAG開発企業をまとめた他社のブログ記事や比較記事が、複数の企業を選ぶ根拠として使われていました。
たとえば、ファーストネットジャパンのRAG開発会社紹介記事や、riplaのRAG開発企業に関する記事などです。製品の紹介では、PR TIMESの発表記事も利用されていました。
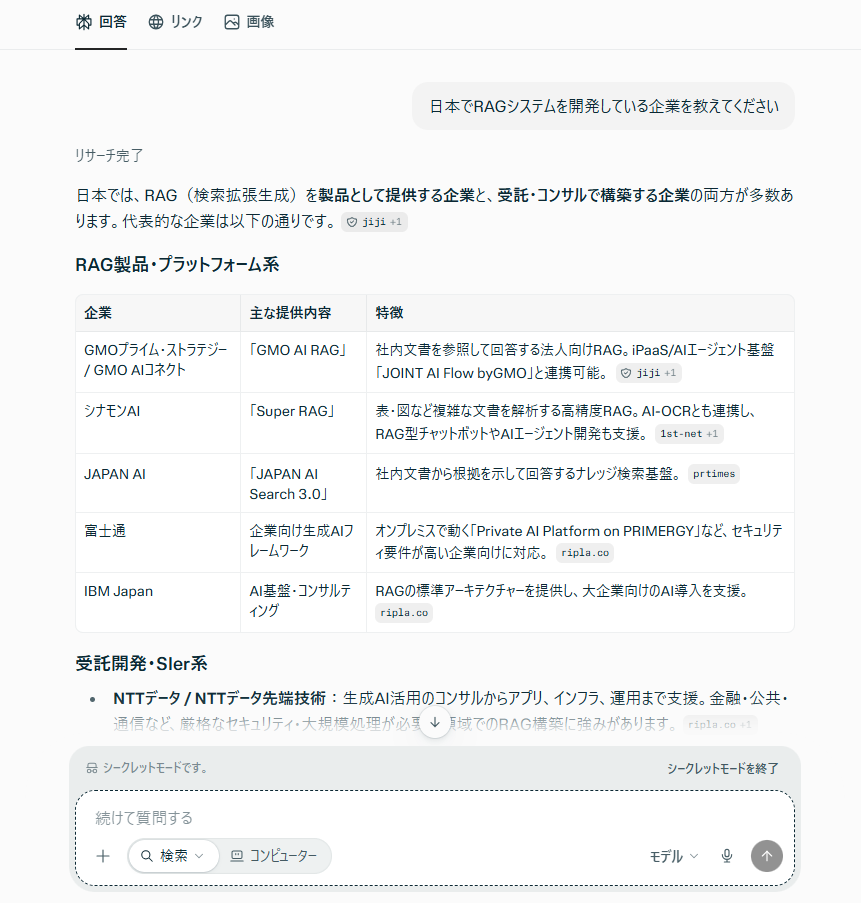
まだ1回の結果なので、「Perplexityは比較記事を重視する」とまでは言えません。ただ今回の結果では、自社サイトの情報だけでなく、第三者のWebページで企業がどのように扱われているかも回答に表れていました。
Copilot:第三者の企業比較・まとめ記事が中心
Profoundの調査では、Copilotは質問を短い検索向けのキーワードへ圧縮する傾向が観測されています。
今回の回答では、複数の企業候補とともに、RAGベンダーを選ぶ際のポイントが提示されました。特徴的だったのは引用元で、企業各社の公式サイトではなく、RAGや生成AIの開発会社を紹介する第三者の記事が中心でした。
具体的には、AI Market、シースリーレーヴ、発注ナビの記事が、複数の企業候補を挙げる根拠として使われていました。
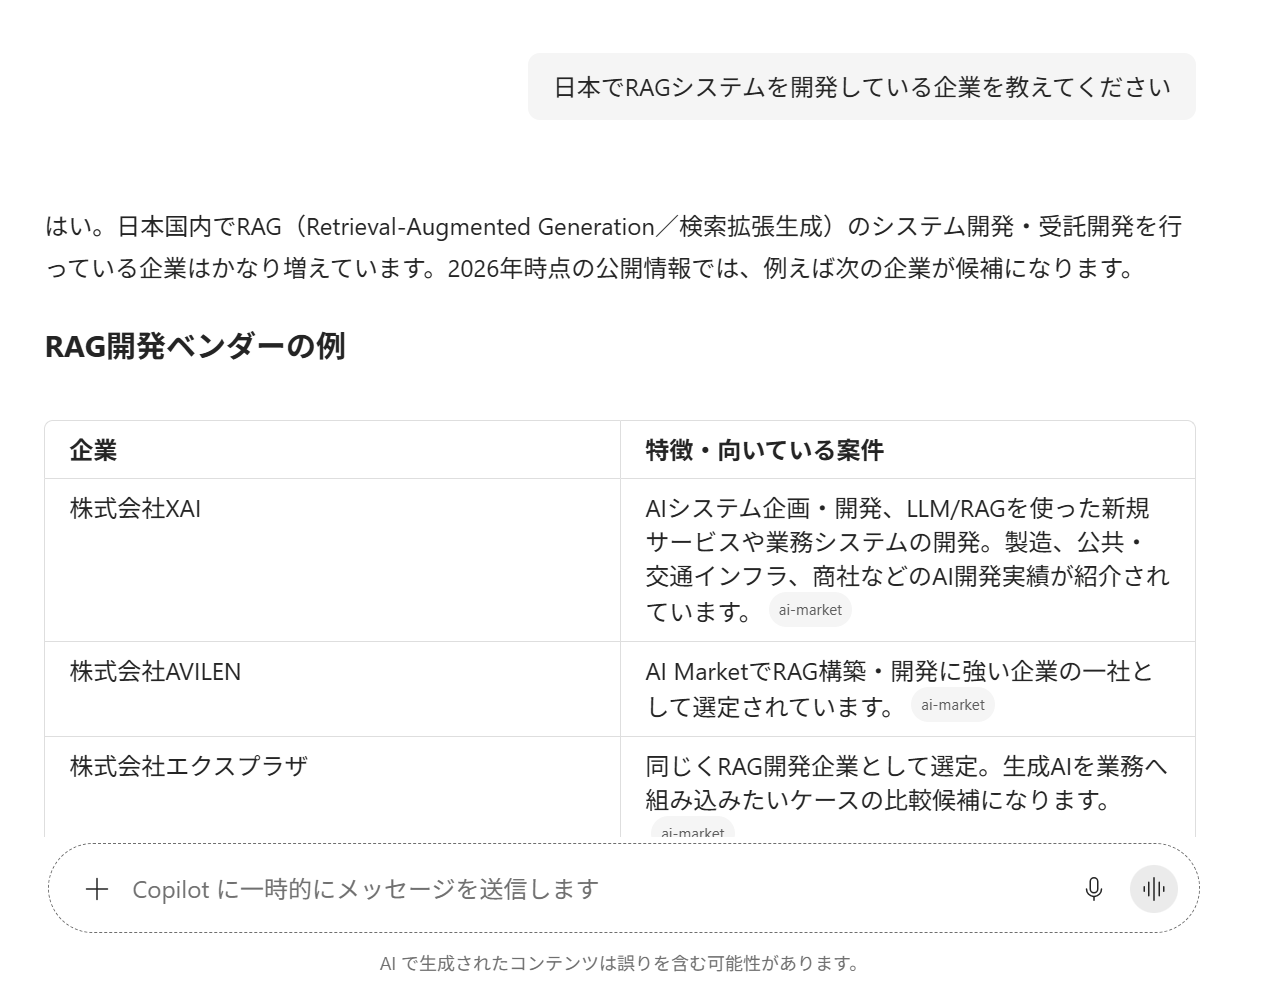
今回の結果を見る限りでは、企業自身がRAGへの取り組みを発信するだけでなく、第三者の記事で「RAG開発企業」として扱われているかどうかも、企業検索では確認しておきたいポイントになりそうです。
Gemini:企業をタイプごとに分類して提示
BrightEdgeの調査では、Geminiの引用元として政府・学術機関・主要業界団体などの情報源が一定割合含まれていたと報告されています(BrightEdgeの調査)。ただし、これは今回の質問に対する回答そのものを分析したものではありません。
今回の回答では、企業を単純に並べるのではなく、次のようなタイプに分類していました。
- 生成AI・AI特化型ベンダー
- 大手SIer・ITベンダー
- アジリティやオーダーメイドに強い開発会社
また、各企業について、SaaS型なのか個別開発なのか、得意とするクラウド環境、精度改善への対応などを踏まえて特徴を説明していました。
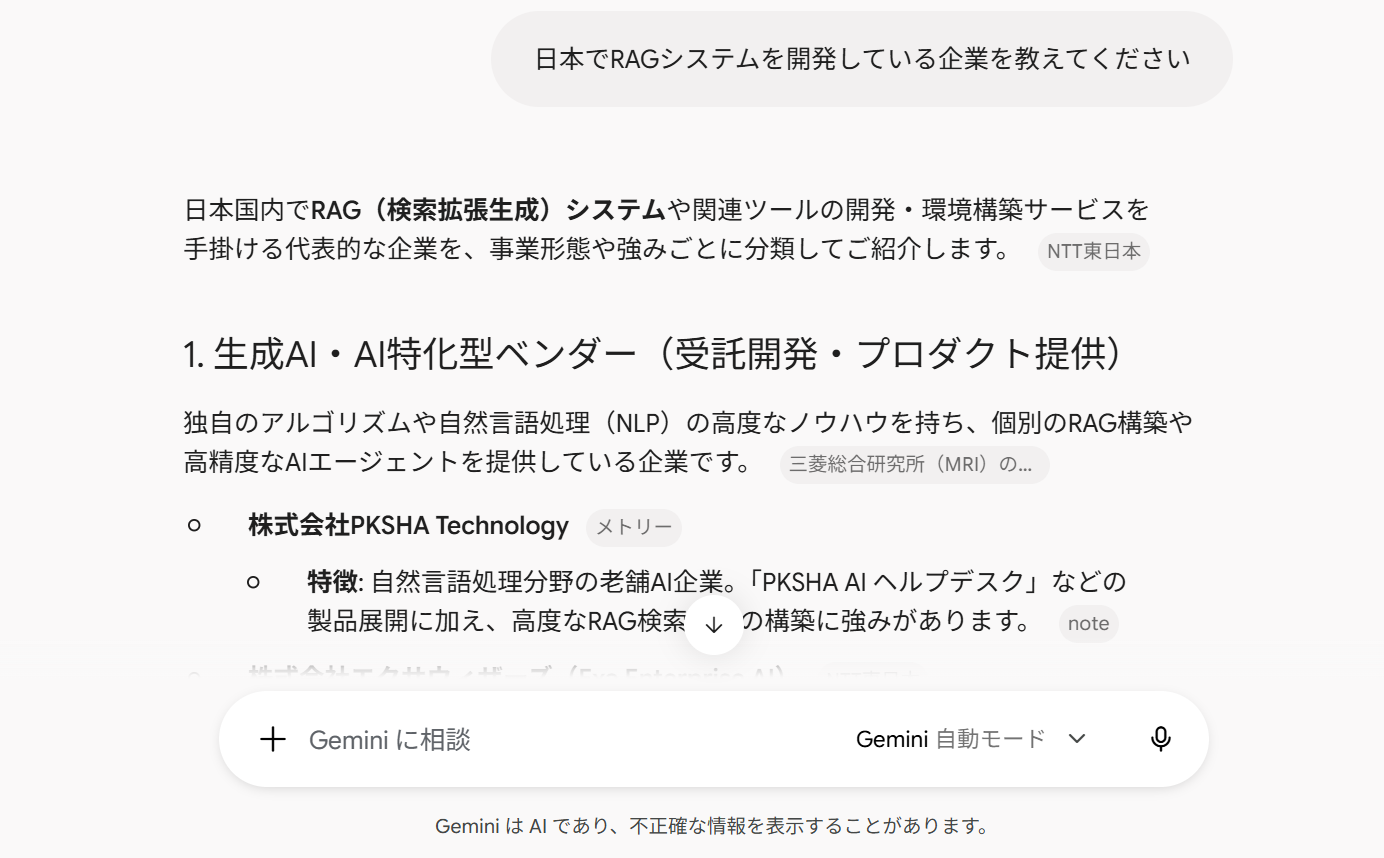
一方、今回記録した回答では、ChatGPTやPerplexityのように個々の企業説明と根拠URLの対応を確認できませんでした。そのためGeminiについては、情報源の種類ではなく、企業をどのように分類し、説明したかを主な観察対象としています。
Claude:検索結果とモデルの一般知識を分けて説明
AnthropicのAPI向け公式資料では、Claudeが検索クエリを生成し、先に得た結果をもとに追加検索や検索語の調整を行う場合があると説明されています。ただし、APIの仕様と一般向けClaudeの内部処理が同一だと確認できたわけではないため、今回は画面上で確認できた回答だけを扱います。
今回の回答では、まず「Web検索で確認できた企業」を挙げ、その後に「今回の検索では確認していないが、一般的な知識では関連企業として認識している企業」を別枠で補足していました。
検索結果から挙げた企業についても、具体的な製品・サービス、RAGの精度や利用状況に関する公開情報、RAG開発会社の比較記事などをもとに説明していました。
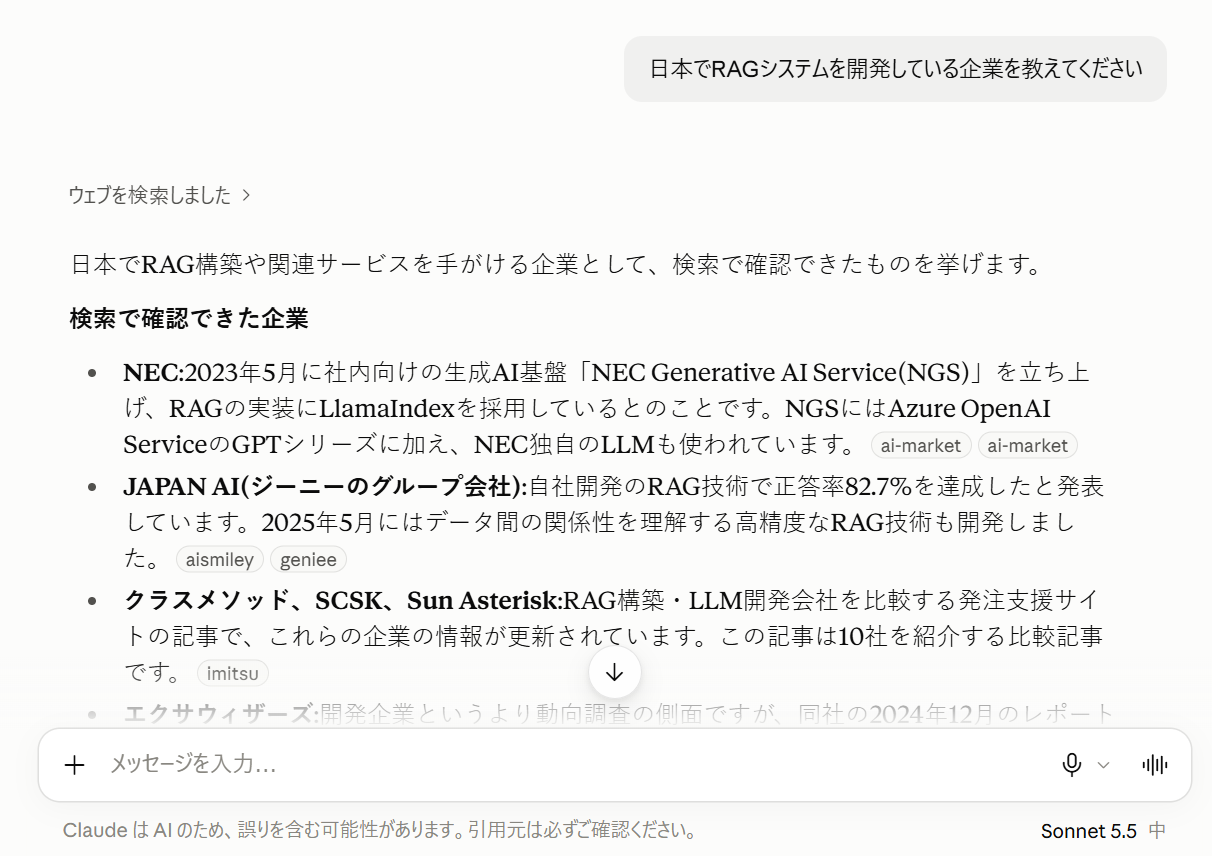
ほかのAIと比べて、今回取得したWeb情報に基づく内容と、モデルが一般知識として補足した内容を明示的に分けていた点が印象的でした。
5つの生成AIを比較すると
今回の結果を、企業名ではなく回答の作り方と情報源の観点で整理すると、次のようになりました。
| AI | 今回の回答で特徴的だったこと | 今回目立った情報源 |
|---|---|---|
| ChatGPT | 各社の特徴や用途まで整理して提示 | 企業公式サイト、製品ページ、導入事例、公式発表 |
| Perplexity | 製品系・受託開発系などに分けて提示 | 公式情報に加え、第三者の企業比較・まとめ記事 |
| Copilot | 多数の候補企業と選定ポイントを提示 | 第三者の企業比較・まとめ記事が中心 |
| Gemini | AI特化、大手SIer、開発会社など企業タイプごとに分類 | 今回記録した回答では、個々の説明と根拠URLの対応を確認できず |
| Claude | Web検索で確認した企業と一般知識による補足を分離 | 企業の公開情報、比較記事、モデルの一般知識による補足 |
※ これは今回それぞれのAIで1回ずつ実行した結果です。各サービスの恒常的な特徴や優劣を示すものではありません。
自社サイトだけを整えればよい、という話でもなさそう
実際に試す前は、自社サイトに「RAGを開発しています」「RAGの導入実績があります」と分かりやすく書いておけば、生成AIにも見つけてもらいやすくなるのではないかと考えていました。
しかし今回の結果を見ると、そこまで単純でもなさそうです。
ChatGPTでは、企業公式の製品ページや導入事例が目立ちました。一方、Perplexityでは公式情報に加えて第三者の比較記事が使われ、Copilotでは第三者の企業比較・まとめ記事が引用元の中心になっていました。
今回の結果だけを見ると、生成AIが企業を見つける経路は、次のように複数存在すると考えた方がよさそうです。
|
1 2 3 4 5 6 7 8 9 10 11 |
自社の公式サイト ├ 製品・サービスページ ├ 導入事例 └ 技術記事 + Web上の第三者情報 ├ 企業比較記事 ├ 技術系メディア └ ニュース・プレスリリース |
もちろん、今回の結果だけで「第三者の記事に掲載されればAIから選ばれやすくなる」とまでは言えません。
ただ、自社が何を発信しているかだけではなく、Web全体で「何に詳しい企業なのか」がどのように表現されているのかも、今後確認する必要がありそうです。
今回調べてみて分かったこと
今回の調査を始めたときは、「生成AIに見つけてもらうには、Webサイトをどのように書けばよいのか」という、いわゆるGEO的な書き方の話をイメージしていました。
しかし調べてみると、生成AIは私たちが入力した質問をそのまま検索しているとは限りません。さらに5つのAIで試すと、同じ質問でも、候補となる企業だけでなく、企業を探すために使われる情報源や回答の整理方法にも違いがありました。
今回の結果から、「こうすれば生成AIに自社を見つけてもらえる」という結論を出すことはできません。それでも、企業側で考えておいた方がよさそうなことは見えてきました。
- 自社が何を得意とする企業なのかを明確にする
- 製品・サービスだけでなく、具体的な導入事例や実績を公開する
- 技術的な取り組みを、技術記事などの形でも残しておく
- 自社サイトだけでなく、Web上で自社がどう扱われているのかも確認する
そして、もう一つ気になることがあります。
今回は「RAGシステムを開発している企業は?」という、企業そのものを探す質問でした。しかし生成AIへの質問には、「RAGの品質を評価する方法は?」のように、企業ではなく技術的な情報を探す質問もあります。
企業として候補に挙がることと、その企業が公開している技術記事が情報源として引用されることは、果たして同じなのでしょうか。
次回は、「企業として生成AIから見つけてもらえるか」だけでなく、「自社が公開している技術記事は、生成AIの情報源として見つけてもらえるのか」という視点でも確認してみたいと思います。
参考にした主な調査・研究
- Profound – What AI engines actually search for
- What Drives AI Citations? – arXiv:2610.15033
- Synthetic Sources? – Allaham & Diakopoulos
- BrightEdge – Why AI Engines Cite Different Sources
- Conductor – How AI Engines Choose and Cite Sources
※ 紹介した数値や傾向は各調査の条件に依存します。現在の仕様や、日本語での同様の挙動を保証するものではありません。
以上、最後までご愛読いただき
ありがとうございました。
お問い合わせは、
以下のフォームへご連絡ください。
関連記事
 松坂
この著者の保持資格
松坂